


Melhorando a performance de platform channels no Flutter
Nos últimos anos, tenho me interessado pelo problema de “como tornamos a comunicação entre o Flutter e sua plataforma host mais rápida e fácil?”

Nos últimos anos, tenho me interessado pelo problema de “Como tornar a comunicação entre o Flutter e a sua plataforma host mais rápida e fácil?” Essa é uma questão de interesse especial para desenvolvedores de plugins Flutter e de add-to-app.
A comunicação entre o Flutter e a plataforma host normalmente é feita com platform channels, então meu foco tem estado ali. No final de 2019, para remediar a quantidade de boilerplate e de código tipado como string necessário para usar platform channels, projetei um pacote codegen, Pigeon, que torna os platform channels type-safe, e a equipe continua melhorando-o. Na primavera de 2020, realizei uma auditoria de performance de platform channels e de foreign function interface (FFI). Agora, direcionei meus esforços para melhorar a performance dos platform channels. Como o Pigeon é construído sobre platform channels, e pretendo criar uma solução de sincronização de dados para múltiplas instâncias do Flutter em cima do Pigeon, esta é uma boa oportunidade para ajudar com as muitas necessidades diferentes dos desenvolvedores e com as minhas iniciativas.
Depois de investigar, consegui identificar cópias desnecessárias dos dados enviados pelos platform channels e removê-las. Abaixo você encontra os resultados dessa mudança e uma visão geral do trabalho que levou à identificação e à remoção das cópias.
Resultados
Depois de remover as cópias desnecessárias ao enviar 1 MB de dados binários do Flutter para a plataforma host com uma resposta de 1 MB, observamos um aumento de performance de aproximadamente 42% no iOS. No Android, os resultados foram um pouco mais complexos. Nossos testes automatizados de performance melhoraram cerca de 15%, enquanto os testes locais apresentaram um aumento de aproximadamente 52% de aumento ao migrar para o novo codec BinaryCodec.INSTANCE_DIRECT. Essa discrepância pode ocorrer porque os testes automatizados de performance rodam em um dispositivo mais antigo, mas também pode ser um artefato de como os microbenchmarks, em particular, se comportam em um dispositivo mais antigo (por exemplo, sobrecarregando o garbage collector). Você pode encontrar o código-fonte do teste automatizado de performance em platform_channels_benchmarks/lib/main.dart.
Para platform channels que usam o StandardMessageCodec, vi um ganho de performance menor (aproximadamente 5% com um payload de 14k). Testei com um grande array de tipos suportados para estressar a codificação e a decodificação. O que descobri foi que o tempo de codificação e decodificação de MessageCodecs superou em muito o tempo gasto copiando as mensagens entre as plataformas. Grande parte desse tempo de codificação vem do custo de percorrer recursivamente uma estrutura de dados e usar reflexão para descobrir o que ela contém.
Então, o resultado pode variar conforme a forma como você usa os platform channels e o seu dispositivo. Se você quer a comunicação mais rápida com platform channels, deve usar BasicMessageChannels com o FlutterBinaryCodec no iOS e BinaryCodec.INSTANCE_DIRECT no Android, e desenvolver seu próprio protocolo para codificar e decodificar mensagens que não dependa de reflexão. (Implementar um novo MessageCodec pode ficar mais limpo.)
Se você quer testar os novos platform channels mais rápidos, eles já estão disponíveis no master canal.
Remoção de cópias em detalhes
Se você não está interessado em um mergulho profundo em como alcancei esses resultados e nos problemas que precisei superar, pare de ler agora. Se você gosta de entender os detalhes, continue.
A API de platform channels não mudou muito desde 2017. Como os platform channels são fundamentais para o funcionamento do engine e dos plugins, eles não são fáceis de mudar. Embora eu tivesse uma ideia geral de como os platform channels funcionam, eles são um tanto intrincados. Então, o primeiro passo para melhorar a performance foi entender exatamente o que eles fazem.
O diagrama a seguir descreve o processo original que o framework seguia quando um platform channel era usado para se comunicar com o iOS a partir do Flutter:
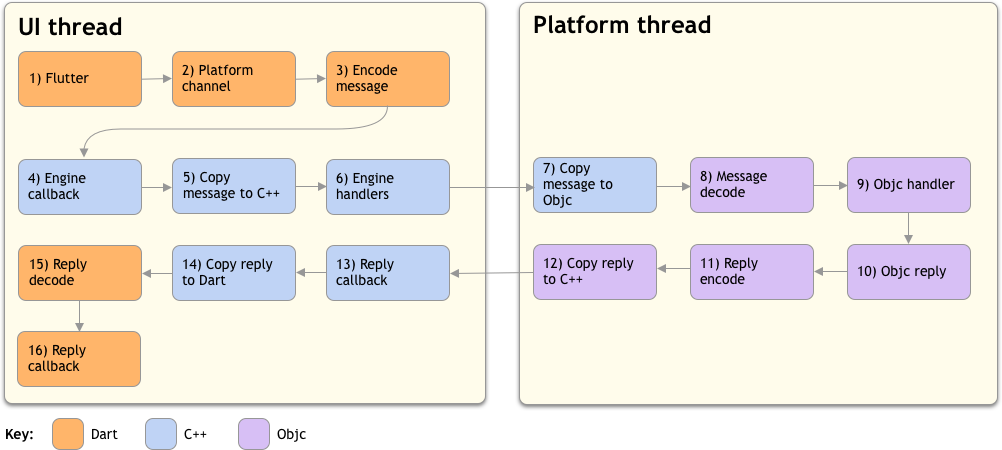
Algumas conclusões do diagrama:
-
A mensagem passa da thread de UI para a thread de plataforma e volta para a thread de UI. (No jargão do engine do Flutter, a thread de UI é onde o Dart é executado, e a thread de plataforma é a thread principal da plataforma host.)
-
A mensagem e sua resposta usam C++ como camada intermediária para a comunicação entre o Flutter e a linguagem-alvo da plataforma host.
-
As informações da mensagem eram copiadas 4 vezes antes de chegar ao handler em Objective-C (Obj-C) (etapas 3, 5, 7 e 8). As etapas 3 e 8 fazem uma tradução, enquanto as etapas 5 e 8 fazem uma cópia, para transferir a propriedade dos dados para um novo layout de memória. O mesmo processo é repetido em sentido inverso para a resposta.
As etapas 1, 9 e 16 são código escrito pelo desenvolvedor que usa o Flutter.
Enviar uma mensagem do Flutter para Java/Kotlin é semelhante, exceto que há uma camada Java Native Interface (JNI) entre C++ e a Java Virtual Machine (JVM).
Depois de estabelecer como os platform channels funcionam, ficou claro que eliminar as cópias feitas ao transferir dados entre essas camadas (como de C++ para Obj-C) é um método óbvio para melhorar a performance. Para isso, o engine do Flutter precisaria colocar os dados na memória de um jeito que fosse acessível diretamente a partir de Java/Obj-C e que tivesse semântica de gerenciamento de memória compatível com a plataforma host.
As mensagens dos platform channels são, em última instância, consumidas pelo método decodeMessage da MessageCodec da plataforma host. No Android, isso significa um ByteBuffer, e no iOS, significa NSData. Os dados em C++ precisam estar de acordo com essas interfaces. Ao abordar esse problema, descobri que as informações da mensagem residiam na memória do C++ como um std::vector dentro de um objeto PlatformMessage, mantido por um shared pointer. Isso significa que os desenvolvedores não podiam remover com segurança a cópia ao enviar os dados do C++ para a plataforma host, porque não havia garantia de que os dados não seriam modificados pelo C++ depois de entregues à plataforma host. Além disso, eu precisava ter cuidado, porque as implementações de BinaryCodec tratavam encodeMessage e decodeMessage como uma operação nula, o que poderia levar o código que usa BinaryCodec a receber, sem querer, um ByteBuffer direto. Embora seja improvável que alguém se surpreenda com mudanças em MessageCodec, raramente alguém implementa o próprio codec. Já usar BinaryCodecs é muito comum.
Depois de ler o código, descobri que, embora o PlatformMessage fosse gerenciado por um shared pointer, semanticamente ele era um unique pointer. A intenção era que apenas um cliente tivesse acesso a ele por vez (o que não era bem assim, porque momentaneamente existiam várias cópias ao passar o PlatformMessage entre threads, mas isso era apenas por conveniência e não era realmente a intenção). Isso significava que podíamos migrar de shared pointers para unique pointers, permitindo passar os dados para a plataforma host com segurança.
Depois de migrar para unique pointers, precisei encontrar uma forma de passar a propriedade das informações do C++ para o Obj-C. (Implementei primeiro o Obj-C, e vou discutir o Java com mais detalhes depois.) As informações estavam armazenadas em um std::vector, que não tem como liberar a propriedade do buffer subjacente. Suas únicas opções são copiar os dados, fornecer um adaptador que tenha o std::vector, ou eliminar o uso de std::vector.
Minha primeira tentativa foi criar uma subclasse de NSData que std::move o std::vector e lesse seus dados a partir dali, eliminando a cópia. Essa tentativa não funcionou bem porque acontece que NSData é um class cluster no Foundation. Isso significa que você não pode simplesmente criar uma subclasse de NSData. Depois de ler muitos documentos da Apple, parece que a recomendação deles é usar composição e encaminhamento de mensagens para fazer um objeto se comportar e parecer um NSData. Isso enganaria quem usa o objeto proxy, exceto quem chama -[NSObject isKindOfClass:]. Embora isso seja improvável, não dava para descartar essa possibilidade. Embora eu ache que talvez fosse possível fazer alguns ajustes no runtime do Obj-C para que o objeto se comportasse como eu queria, ficou complicado. Optei, em vez disso, por mover a memória para fora de std::vector e para uma classe de buffer própria que permite liberar a propriedade dos dados. Assim, pude usar -[NSData dataWithBytesNoCopy:length:] para transferir a propriedade dos dados para o Obj-C.
Repetir esse processo no Android se mostrou um pouco mais difícil. No Android, os platform channels seguem ByteBuffer, que tem o conceito de ByteBuffers diretos, que permitem que o código Java faça interface diretamente com a memória organizada no estilo C/C++. Em pouco tempo, implementei a mudança para ByteBuffers diretos, mas não vi a melhoria que esperava. Passei muito tempo aprendendo as ferramentas de profiling do Android e, no fim, optei por instruções de trace quando elas falhavam ou retornavam coisas em que eu não conseguia acreditar. Acabou que agendar a resposta da mensagem do platform channel na thread de UI, a partir da thread de plataforma, era absurdamente lento, e parecia ser lento de um jeito em que a lentidão aumentava com o payload da mensagem. Resumindo, eu estava compilando a VM do Dart com as flags de compilação erradas, achando que “no-optimization” significava sem link-time optimization, mas a flag era, na verdade, para otimização em tempo de execução.
Na minha empolgação por ter encontrado o meu erro, esqueci das ramificações de usar um ByteBuffer direto ao enviar os dados para o código cliente do Flutter, especificamente por meio de MessageCodecs personalizados ou de clientes de BinaryCodec. Enviar um ByteBuffer direto significa ter um objeto Java que se comunica com a memória C/C++, então, se você deletar a memória C/C++, o Java interage com lixo aleatório e provavelmente vai travar com uma violação de acesso do sistema operacional.
Seguindo o exemplo do iOS, tentei transferir a propriedade da memória C/C++ para o Java, de modo que ela fosse liberada quando o objeto Java fosse coletado pelo garbage collector. Acontece que isso não é possível quando o
ByteBuffer direto é criado a partir do JNI por meio de NewDirectByteBuffer. O JNI não oferece nenhum hook para saber quando um objeto Java é excluído. Você não pode criar uma subclasse de ByteBuffer para que ela chame o JNI quando for finalizada. A única esperança seria alocar o
ByteBuffer direto pela API Java na etapa 5 do diagrama anterior. ByteBuffers diretos alocados pelo Java não têm essa limitação. Introduzir um novo entry-point no Java, porém, seria uma mudança enorme, e quem já trabalhou com JNI sabe que isso é arriscado.
Em vez disso, optei por pedir à equipe que aceitasse ByteBuffers diretos nas chamadas
decodeMessage. No início, introduzi um novo método em MessageCodec, bool wantsDirectByteBufferForDecoding(), para garantir que ninguém recebesse um
ByteBuffer direto sem pedir e sem conhecer a semântica dele (ou seja, quando a memória C/C++ subjacente ainda é válida). Isso se mostrou complicado, e a preocupação era que desenvolvedores ainda assinassem e não conhecessem a semântica dos
ByteBuffers diretos, porque eles funcionam de forma contrária aos ByteBuffers típicos, e poderiam ter a memória C por trás deles excluída sem aviso. Armazenar os buffers codificados era um uso atípico somado a um uso improvável, mas a equipe não conseguia descartar essa possibilidade. Depois de muitas discussões e negociações, decidimos que cada
MessageCodec recebe um ByteBuffer direto que é limpo depois que decodeMessage
é chamado. Assim, se alguém armazenar mensagens codificadas em cache, receberá um erro determinístico e adequado no Java caso tente usar o
ByteBuffer depois que a memória C subjacente for liberada.
Dar a todos acesso aos ganhos de desempenho dos ByteBuffers diretos funcionou muito bem, mas foi uma breaking change para o
BinaryCodec, cujas implementações de encodeMessage e decodeMessage são no-ops: elas apenas repassam a entrada como valor de retorno. Para manter a mesma semântica de memória para o
BinaryCodec, introduzi uma nova variável de instância
que controla se a mensagem decodificada é um ByteBuffer direto (código novo, mais rápido) ou um
ByteBuffer padrão (código antigo, mais lento). Não conseguimos criar uma forma de dar o ganho de velocidade a todos os clientes do
BinaryCodec.
Trabalhos futuros
Agora que a eliminação das cópias está concluída, meus próximos esforços para melhorar a comunicação entre o Flutter e a plataforma host serão:
-
Implementar um
MessageCodeccustomizado para o Pigeon que não dependa de reflection, para codificação e decodificação mais rápidas. -
Implementar platform channels via FFI que permitam chamar do Dart para a plataforma host sem alternar entre a thread da UI e a thread da plataforma.
Espero que você tenha gostado deste mergulho nos detalhes dessa melhoria de desempenho!
Mais do Flutter

Anunciando a interoperabilidade nativa direta estável
FFIgen para Objective-C e JNIgen para Java/Kotlin agora são estáveis, e o Pigeon coloca os dois para trabalhar, para que seus plugins chamem código nativo diretamente


Como converti o GenLatte para Dart full stack
E reduzi a conta de servidor do app
